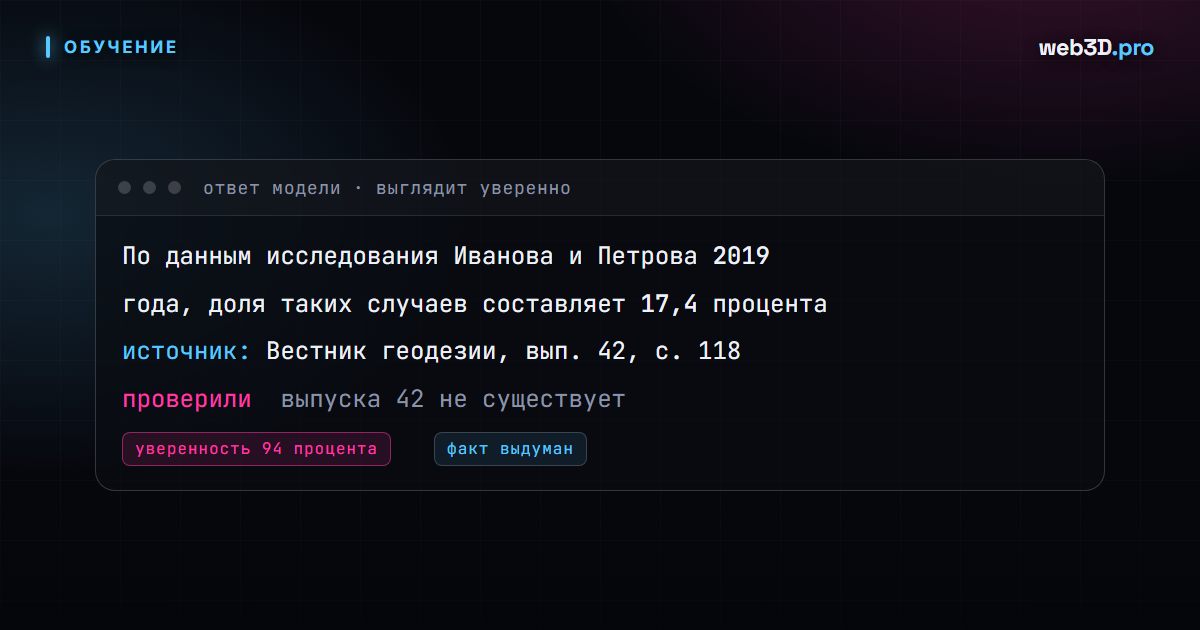
Галлюцинация нейросети это ответ, который звучит уверенно и гладко, но содержит выдуманный факт: несуществующую книгу, неверную цифру, функцию библиотеки, которой никогда не было. Ниже разбираем, откуда это берётся, где риск выше всего и какие приёмы реально снижают число ошибок.
Быстрые ответы на самые частые вопросы:
- Почему нейросеть врёт. Она не ищет факт в базе, а предсказывает самое правдоподобное продолжение текста. Если данных мало, правдоподобное и верное расходятся.
- Где ошибается чаще всего. Ссылки на источники, точные цифры, даты, имена, версии программ, законы и цены конкретной страны.
- Где ей можно доверять. Работа с текстом, который вы дали сами: пересказ, структура, правка, поиск противоречий. Плюс общие объяснения и рассуждения.
- Самый действенный приём. Дать модели исходный документ и попросить отвечать только по нему, с цитатой нужного места.
- Помогает ли поиск в интернете. Да, заметно, но не до нуля: модель может неверно пересказать найденную страницу. Ссылки всё равно открывать.
- Исчезнут ли галлюцинации. Нет. С каждым поколением их меньше, но это свойство самого принципа генерации, а не баг одной версии.
Дальше по порядку: механика ошибки, типовые виды галлюцинаций с примерами, карта риска по задачам, рабочие приёмы и короткий чек-лист проверки ответа.
Что такое галлюцинация нейросети простыми словами
Языковая модель не хранит знания как справочник с проверенными записями. Во время обучения она прочитала огромный массив текстов и научилась угадывать, какое слово обычно идёт следующим. Когда вы задаёте вопрос, модель строит ответ слово за словом, каждый раз выбирая вероятное продолжение. Подробно этот механизм разобран в материале о том, как ИИ генерирует текст через токены.
Отсюда главное: у модели нет отдельного сигнала «этого я не знаю». Фраза «книга вышла в 2019 году в издательстве…» для неё такое же нормальное продолжение, как и любое другое. Если настоящего факта в данных было мало, модель подставит то, что статистически похоже на правду. Получается текст правильной формы с неправильным содержимым.
Слово «галлюцинация» прижилось потому, что модель описывает несуществующее так же спокойно и подробно, как реальное. Никакого злого умысла и попытки обмануть тут нет, есть только вероятности.
Почему модели ошибаются: четыре причины
Мало данных о конкретном факте
О популярной программе в обучении были тысячи текстов, о редком плагине три упоминания на форуме. Чем реже тема, тем больше модель достраивает по аналогии. Поэтому про Blender в целом она рассказывает уверенно и верно, а про параметр малоизвестного аддона может сочинить.
Противоречивые источники
В интернете много устаревших инструкций, ошибок и споров. Модель усредняет то, что видела, и иногда склеивает две версии в одну несуществующую: интерфейс из старой версии программы и название функции из новой.
Дата среза знаний
У каждой модели есть момент, после которого она ничего не читала. Вопросы о свежих ценах, релизах и законах она закрывает по старым данным и не всегда об этом предупреждает. Особенно это заметно в быстро меняющихся темах вроде тарифов нейросетей и версий игровых движков.
Как настраивали поведение
При дообучении на оценках людей модели поощряли за полезные и полные ответы. Осторожное «не знаю» часто оценивалось как бесполезное. В итоге модели привыкли отвечать в любом случае. Разработчики это исправляют, и новые версии заметно чаще признают неуверенность, но привычка «лучше ответить» до конца не ушла.
Отдельно влияет настройка случайности. Чем выше параметр temperature, тем охотнее модель выбирает менее вероятные слова и тем больше простора для выдумки. Как это устроено, объясняем в статье про temperature и top-p.
Виды галлюцинаций с примерами
Несуществующие источники. Самый известный тип. Модель называет книгу с правдоподобным названием, реальным автором и годом выпуска, которой никогда не было. Или научную статью с номером журнала. Правило простое: источник, который вы лично не открыли, не цитируете.
Искажённые цитаты. Автор реальный, мысль похожая, а формулировка другая или вырвана из контекста так, что смысл перевернулся.
Склеенные факты. Правильный человек и чужая должность, правильное событие и соседний год, верная компания и цифры от конкурента.
Технические детали. Для 3D-художника и разработчика это главная зона риска. Модель уверенно называет пункт меню, которого нет в вашей версии Blender, параметр функции из Python API, который убрали два релиза назад, или флаг командной строки, похожий на настоящий. Код выглядит правильно и падает при запуске.
Местная специфика. Налоги, законы, цены и процедуры часто берутся из другой страны. Вопрос про договор с заказчиком в России легко получает ответ по американской практике.
Арифметика и подсчёты. Длинные расчёты в уме модель делает хуже, чем кажется: может потерять разряд или перепутать порядок действий. Для расчётов лучше просить формулу или код, а не готовое число.
Карта риска: где проверять, а где можно доверять
Удобно делить задачи по тому, откуда модель берёт факты: из вашего текста или из собственной памяти.
| Задача | Риск | Что делать |
|---|---|---|
| Пересказ, правка, структура вашего текста | Низкий | Пробежать глазами итог |
| Объяснение общих принципов и понятий | Низкий | Доверять, уточнять детали |
| Генерация идей, планов, вариантов | Низкий | Факты внутри идей проверить |
| Код на популярном языке по типовой задаче | Средний | Запустить и протестировать |
| Настройки и меню конкретной версии программы | Высокий | Сверить с документацией |
| Цифры, статистика, даты, цены | Высокий | Найти первоисточник |
| Ссылки на книги, статьи, исследования | Очень высокий | Открыть каждую |
| Право, медицина, финансы | Очень высокий | Только как черновик для специалиста |
Принцип за таблицей один: чем больше ответ опирается на память модели и чем точнее нужен факт, тем выше риск. Рассуждения по данным, которые вы положили в запрос, почти всегда надёжнее ответа «из головы».
Как снизить риск: восемь рабочих приёмов
1. Давайте материал, а не просите его вспомнить
Запрос «проанализируй этот документ» на порядок надёжнее, чем «расскажи о теме». Вставьте текст, документацию, таблицу или PDF и попросите работать только с ними. Большие документы помещаются целиком: как этим пользоваться, разобрано в статьях про контекстное окно Claude и анализ PDF.
2. Разрешите сказать «не знаю»
Добавьте в запрос: «Если не уверен или данных нет, прямо скажи об этом, не додумывай». Модели заметно лучше признают пробелы, когда это явно разрешено. Такую инструкцию удобно вынести в системный промпт или настройки памяти, чтобы не писать каждый раз.
3. Требуйте цитату
«Ответь и приведи дословную цитату из документа, на которую опираешься». Если цитаты в тексте нет, ответ сразу видно как выдуманный. Это самый быстрый способ проверки.
4. Включайте поиск для свежих фактов
ChatGPT, Claude, Gemini и Perplexity умеют искать в интернете. Для цен, версий и новостей это обязательно. Но помните: модель может неточно пересказать найденную страницу, поэтому ключевые цифры сверяйте по ссылке.
5. Просите рассуждать по шагам
Когда модель сначала расписывает ход мысли, ошибки в логике и расчётах всплывают раньше и их легче заметить. Приём подробно разобран в материале про Chain-of-Thought.
6. Задавайте формат ответа
Чем строже рамка, тем меньше простора для выдумки. Попросите таблицу с колонкой «источник» или ответ в виде JSON с полем «уверенность». Как получать от модели чистый структурированный ответ, описано в статье про структурированный вывод.
7. Перепроверяйте вторым запросом
Скопируйте ответ в новый чат и попросите найти в нём фактические ошибки и неподтверждённые утверждения. Свежий взгляд без предыдущего контекста часто находит то, что пропустила первая сессия. Ещё надёжнее отдать проверку другой модели.
8. Подключайте свою базу знаний
Если вы регулярно спрашиваете по одним и тем же документам, их можно подключить к модели постоянно. Такой подход называется RAG: модель сначала находит нужный фрагмент в ваших файлах и только потом отвечает. Разбор в статье про RAG и базы знаний.
Галлюцинации в работе 3D-художника и разработчика
В нашей сфере ошибки нейросетей обычно не опасны, но съедают время. Типичные случаи:
- скрипт для Blender обращается к атрибуту, которого нет в вашей версии API, и падает с ошибкой;
- инструкция ведёт в меню, которое переехало или переименовано в новой версии программы;
- рекомендованные параметры печати или рендера взяты «с потолка» и не подходят вашему железу;
- ссылка на аддон, урок или модель ведёт на несуществующую страницу.
Что помогает: всегда называйте точную версию программы, прикладывайте текст ошибки целиком и просите проверить решение по официальной документации. В автономных сценариях, где AI-агенты сами выполняют действия, ставьте проверку результата отдельным шагом: агент, который поверил своей галлюцинации, уверенно продолжит работу по неверному пути.
И ещё одно правило: не отправляйте в чат-бот конфиденциальные данные клиента только ради того, чтобы модель «точно не ошиблась». О том, где проходит граница, рассказываем в материале про безопасность данных при работе с ИИ.
Чек-лист: проверка ответа нейросети за минуту
- Есть ли в ответе конкретные цифры, даты, имена, названия источников? Каждую такую деталь отметьте.
- Опирается ли ответ на ваш документ или на память модели? Если на память, отмеченное проверяется в первоисточнике.
- Открываются ли ссылки и говорят ли страницы то же самое?
- Совпадает ли версия программы в инструкции с вашей?
- Запускается ли код без ошибок на тестовых данных?
- Если цена ошибки высокая, проверил ли ответ второй источник или специалист?
Итог
Галлюцинации это не сбой, а обратная сторона того, как работают языковые модели. Полностью их не убрать, но на практике риск хорошо управляется. Используйте нейросеть как сильного помощника в работе с текстом, кодом и идеями, давайте ей исходные материалы, разрешайте признавать незнание и проверяйте всё, что будет опубликовано, отправлено клиенту или станет основой для решения. Если хотите глубже освоить постановку запросов, начните с обзора техник промпт-инжиниринга.
Частые вопросы
Как отличить галлюцинацию от правды в ответе нейросети?
По виду никак: выдуманный факт звучит так же уверенно, как настоящий. Насторожиться стоит при точных цифрах без источника, именах в конкретных ролях, цитатах в кавычках и ссылках на книги и статьи. Проверка простая: поиск по ключевой фразе, открытие ссылки или вопрос к модели с просьбой привести дословную цитату из документа.
Какая нейросеть галлюцинирует меньше всех?
Устойчивого лидера нет: актуальные версии ChatGPT, Claude и Gemini близки, а рейтинги меняются с каждым релизом. Гораздо сильнее модели влияет постановка задачи. Ответ по приложенному документу с включённым поиском почти у любой современной модели надёжнее, чем ответ самой точной модели по памяти.
Можно ли полностью избавиться от галлюцинаций?
Нет, при нынешнем принципе генерации текста это невозможно. Снизить до приемлемого уровня можно: работа по документам, база знаний через RAG, поиск в интернете, строгий формат ответа и проверка второй моделью. В специализированных системах для медицины и права добавляют обязательную сверку с источниками, но и там последнее слово остаётся за человеком.
Почему нейросеть уверенно отвечает, а не говорит «не знаю»?
У модели нет встроенного ощущения неуверенности, она просто достраивает вероятный текст. Вдобавок при обучении на оценках людей полные ответы ценились выше осторожных. Новые версии чаще признают пробелы, а явная фраза в запросе «если не знаешь, так и скажи» заметно усиливает это поведение.
Влияет ли язык запроса на количество ошибок?
Влияет. По узким темам текстов на английском в обучении обычно больше, поэтому ответы по-английски бывают точнее. Для редких технических вопросов имеет смысл задать вопрос на английском или попросить модель сверяться с англоязычной документацией, а итог получить на русском.
Галлюцинирует ли нейросеть, если включён поиск в интернете?
Реже, но да. Модель может взять устаревшую страницу, неточно пересказать найденное или смешать данные двух источников. Поиск снимает проблему среза знаний, но не отменяет проверку: ключевые цифры и утверждения сверяйте по ссылкам, которые модель приводит.